 Cesar Schutz
Um cenário comum: um microsserviço Spring Boot roda no Kubernetes como API e passa a precisar de uma rotina periódica, por exemplo ler uma lista de registros do banco, aplicar validações e publicar parte deles num tópico SNS. A lógica de negócio já está no serviço, então a pergunta não é se o código será reaproveitado, e sim onde essa rotina vai rodar.
Duas abordagens aparecem com frequência. Ambas funcionam e reaproveitam o código, mas com trade-offs diferentes. Neste post, comparo as duas critério por critério, incluindo onde cada uma leva vantagem, e explico por que, para esse tipo de carga, a balança pende para a primeira.
Versões. Os exemplos de código foram testados com Spring Boot 4.1.1 (que traz o Spring Batch 6.0.5), Java 21 e PostgreSQL 16, e o CronJob foi validado contra o schema da API do Kubernetes 1.37. Onde o Spring Boot 4 mudou o comportamento em relação ao 3.x, o texto avisa.
As duas abordagens#
A — CronJob com a mesma imagem e outro perfil do Spring#
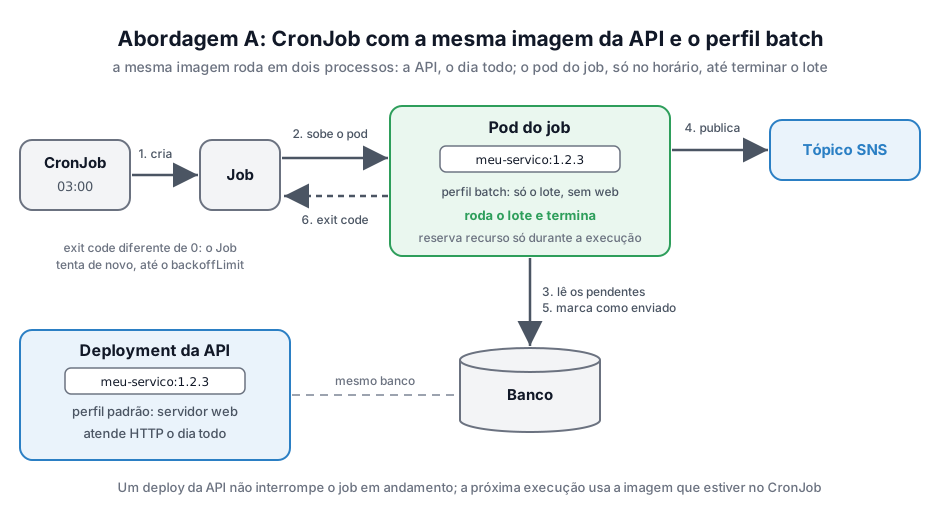
A API continua no Deployment de sempre. No horário agendado, o CronJob cria um Job, que sobe um pod com a mesma imagem da API e o perfil batch: sem servidor web, esse pod executa o job com Spring Batch e termina. O exit code informa ao Kubernetes se deu certo.
B — CronJob chama um endpoint que enfileira uma mensagem no SQS, e a própria API a consome#
No horário agendado, o CronJob chama um endpoint da API com curl. O endpoint publica uma única mensagem numa fila SQS, um pedido para processar os pendentes, e responde 202 Accepted, sem consultar o banco. Um dos pods da API consome essa mensagem (por exemplo, com o @SqsListener do Spring Cloud AWS): lê os registros pendentes no banco e processa um a um, publicando no SNS e marcando o status de cada registro. Se der erro, a mensagem não é apagada e volta a ficar visível na fila (ela nunca sai de lá; só fica invisível enquanto é processada), e a nova tentativa segue de onde a anterior parou, porque o banco diz o que já foi enviado. Depois de N tentativas, a mensagem vai para a DLQ (dead-letter queue, a fila das mensagens que falharam).
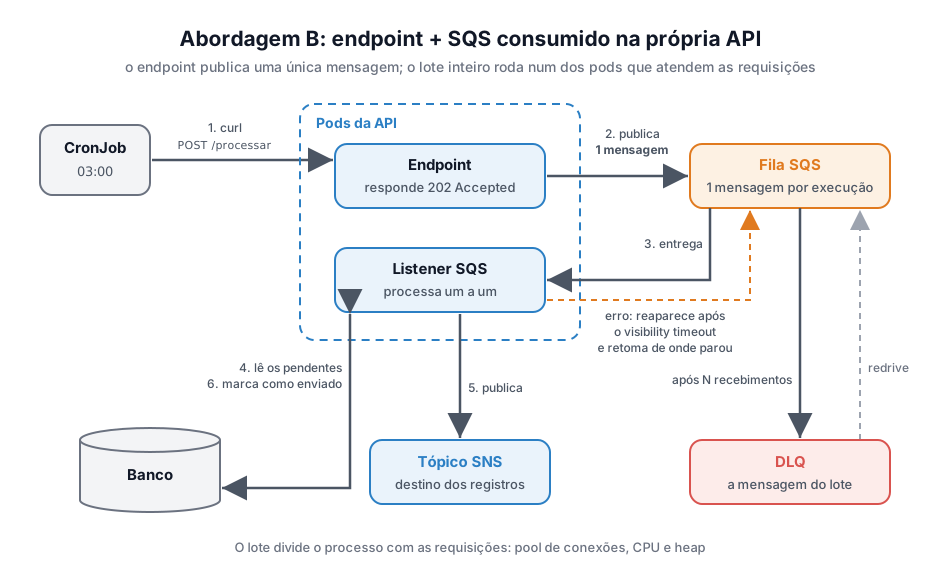
A abordagem B não é um antipadrão. Entre os exemplos de gatilho agendado para processamento em segundo plano, a Microsoft cita exatamente esse desenho: um timer em outra aplicação envia periodicamente uma requisição a uma API, e a API dispara a tarefa (Microsoft — Best practices for background jobs). A discussão aqui é de trade-off.
O padrão por trás da abordagem A#
Rodar a mesma base de código como tipos diferentes de processo é um princípio do Twelve-Factor App (fator VIII, Concurrency): o processo web atende HTTP, e o worker executa tarefas longas em segundo plano.
Chris Jones, da AWS Professional Services, descreve uma evolução em três passos em Rethinking Java @Scheduled Tasks in Kubernetes (The New Stack, 2023): primeiro o @Scheduled dentro da API, depois um CronJob que chama um endpoint via curl e, por fim, um CronJob que roda a mesma imagem da API com um ponto de entrada alternativo. Ele detalha o padrão no AWS Open Source Blog, em Alternative JAR Entry Points Using Java Dependency Injection Frameworks, com um código de exemplo em que o main escolhe o ponto de entrada por uma variável de ambiente própria (ALTERNATIVE_ENTRY_POINT). No Spring Boot, um caminho comum para o mesmo efeito é um perfil (Spring Boot — Profiles): o perfil batch troca beans e configuração e é ativado no CronJob pela variável SPRING_PROFILES_ACTIVE, como mostra a seção Como montar a abordagem A.
Uma alternativa frequente ao primeiro passo, @Scheduled com ShedLock, só impede que duas réplicas rodem a tarefa ao mesmo tempo. O processamento continua dentro da API, com os problemas dos critérios 1 a 4 e sem os ganhos da fila.
Mahmoud Ben Hassine, líder do projeto Spring Batch, mostra como rodar jobs do Spring Batch como Jobs do Kubernetes em Spring Batch on Kubernetes: Efficient batch processing at scale (Spring blog, 2021). O texto é da época do Spring Batch 4; o que mudou desde então aparece ao longo deste post.
Critério a critério#
1. Disputa de recursos com quem atende o usuário#
Na abordagem B, o lote roda dentro de um pod da API, o que recebeu a mensagem, e esse pod continua atendendo a sua parte das requisições. O batch e as requisições HTTP passam a dividir o mesmo processo:
- Pool de conexões. O HikariCP, pool que o Spring Boot usa por padrão, abre no máximo 10 conexões, e o lote usa esse mesmo pool. Processando em série, ele ocupa uma conexão por vez; se o consumidor dividir o lote entre várias threads para terminar antes, ocupa várias, e as requisições da API esperam por uma conexão livre até estourar o timeout (30 s por padrão).
- CPU. O limite de CPU do container é um só: o que o batch consome, as requisições que caem nesse pod perdem em latência.
- Heap. O heap é a área de memória da JVM onde vivem os objetos. Processar grandes volumes aumenta o trabalho do garbage collector, e as pausas dele atingem a aplicação inteira. No limite, a JVM lança
OutOfMemoryError, ou o container passa do limite de memória e é morto pelo kernel (OOMKilled), levando junto as requisições em andamento.
Isolar recursos por tipo de carga, para que uma não esgote a outra, é o padrão Bulkhead, popularizado por Michael Nygard em Release It! e documentado pela Microsoft (Bulkhead pattern). Martin Kleppmann ajuda a entender por que as duas cargas não combinam: em serviços online, a principal medida de desempenho é o tempo de resposta, e a disponibilidade costuma ser crítica; em sistemas batch, é o throughput (Designing Data-Intensive Applications, 1ª ed., cap. 10). O Borg, gerenciador de clusters do Google e antecessor do Kubernetes, trata serviços de longa duração e jobs batch como classes distintas de carga, com prioridades diferentes (Verma et al., EuroSys 2015).
Na abordagem A, o job roda num pod separado, com seus próprios requests e limites de CPU e memória e seu pool de conexões.
Ressalva: o banco continua compartilhado. O pod separado isola o processo, não o banco. Por isso, o job deve ter um pool pequeno (mas não menor que o número de threads do step) e chunks, a quantidade de itens gravados por transação, bem dimensionados.
2. Deploy da API no meio do processamento#
Na abordagem B, um deploy da API feito durante a janela do batch acontece no meio do processamento. No rolling update, cada pod antigo recebe SIGTERM e tem o grace period (30 segundos por padrão) para encerrar antes do SIGKILL (Kubernetes — término de pods; o ciclo completo está em SIGTERM e SIGKILL). O graceful shutdown do Spring Boot cuida das requisições HTTP (Spring Boot — Graceful shutdown); o listener da fila tem prazo próprio. Quando chega a vez do pod que está com a mensagem do lote:
- o listener para de buscar mensagens e espera a que está em andamento, no Spring Cloud AWS até 20 s por padrão (
listenerShutdownTimeout). Um lote de minutos não termina nesse prazo, e o processamento é cancelado; - como não foi concluída, a mensagem não foi apagada da fila: reaparece depois do visibility timeout (o prazo em que a mensagem recebida fica invisível para os outros consumidores), e um pod da versão nova a recebe e segue de onde o anterior parou, pelo status no banco. Se o registro que estava em andamento já tinha sido publicado no SNS, mas ainda não tinha sido marcado, ele é enviado de novo;
- o lote termina em duas versões do código: parte processada pela antiga, parte pela nova.
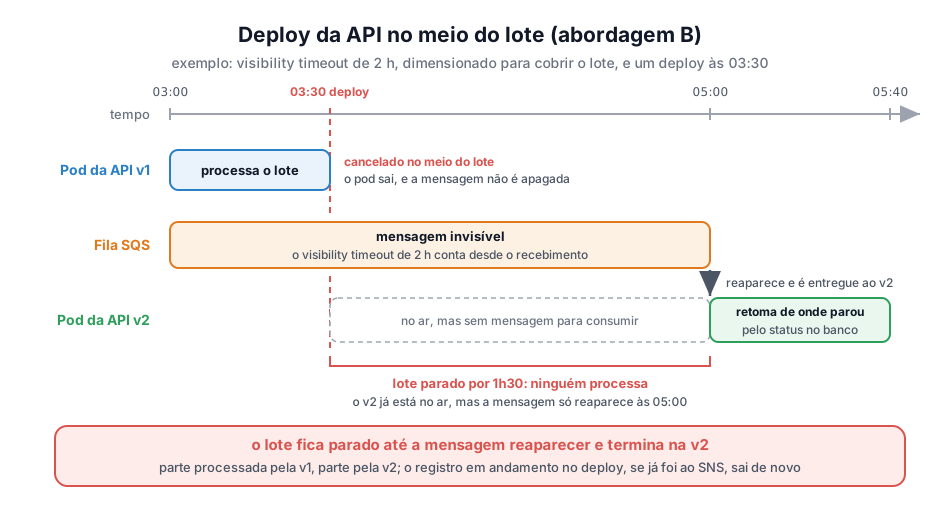
Como a mensagem é uma só, o deploy não põe em risco só o registro em andamento: o lote inteiro para, e a retomada espera o visibility timeout expirar. Se ele foi dimensionado para cobrir o lote (critério 6), a espera pode ser longa: no exemplo, um deploy às 03:30 deixa o lote parado até as 05:00. Aumentar o grace period não resolve: ele é só um teto, não muda o prazo do listener e teria de cobrir o lote inteiro. O resultado costuma ser o time evitando deploy na janela do batch.
Na abordagem A, o deploy da API não toca no pod do job. Nem mesmo uma atualização do CronJob afeta o que já está rodando: as mudanças valem só para os Jobs criados depois, e os que já começaram seguem sem alteração (Kubernetes — CronJob). O job de hoje termina com a versão com que começou, e a nova versão entra na próxima execução. Isso vale para o código, não para o banco: se a versão nova da API roda migrações, elas precisam ser compatíveis com o job que ainda está rodando (expand/contract), a mesma disciplina que o próprio rolling update já exige.
3. Recurso reservado o dia inteiro#
No Kubernetes, cada container declara quanto de memória e CPU reserva no cluster (os requests). Desde a versão 1.35 (estável; em beta desde a 1.33), dá para redimensionar um pod em execução (Kubernetes — Resizing Pods), mas nada no Kubernetes faz isso sozinho só nos minutos em que o batch roda. E, numa JVM, memória a mais sem reiniciar o container não aumenta o heap, porque o tamanho máximo dele é fixado quando a JVM sobe. O Vertical Pod Autoscaler, instalado à parte, também não resolve: para memória, ele considera o pico de cada período de 24 horas, então recomendaria reservar o pico do batch o dia inteiro.
Na abordagem B, cada réplica da API precisa de folga para o pico do batch, 24 horas por dia: qualquer uma pode receber a mensagem e rodar o lote inteiro (critério 6). Essa folga precisa estar no request: memória não se comprime, e, quando falta memória no nó, os pods que passam do próprio request tendem a ser os primeiros despejados (Kubernetes — requests e limits). Um exemplo com números hipotéticos: a API precisa de 512 MB, e o lote, de mais 1 GB. Como qualquer réplica pode recebê-lo, cada uma reserva 1,5 GB, e, com três réplicas, são 4,5 GB reservados o tempo todo. Na abordagem A, são 1,5 GB para a API e 1 GB para o pod do job, só enquanto ele roda: terminado o Job, o pod fica como Completed e deixa de reservar CPU e memória. Ele pode continuar existindo como registro, para consulta de logs, até ser removido pelo limite de histórico do CronJob (Kubernetes — Jobs). O paper do Borg registra o mesmo desperdício do lado dos serviços: jobs de produção costumam reservar recurso para picos raros e não usá-lo na maior parte do tempo.
Sobre a fatura: o SQS custa pouco, e o nível gratuito inclui 1 milhão de requisições por mês, somadas todas as filas da conta (Amazon SQS — Pricing). O que pesa não é a conta do SQS, e sim o custo total de propriedade: recurso reservado e mais peças para provisionar, proteger e monitorar em cada ambiente.
4. Autoscaling reagindo ao batch, e não aos usuários#
O HPA (Horizontal Pod Autoscaler) adiciona e remove réplicas da API conforme uma métrica, normalmente CPU. A premissa é que CPU alta significa mais usuários. Com o batch dentro da API, essa premissa quebra:
- o HPA sobe réplicas que nenhum usuário está usando, e você paga por elas. E elas nem ajudam o lote: a mensagem é uma só e já está num pod;
- quando a média de CPU cai, o HPA remove réplicas depois da janela de estabilização (5 minutos por padrão), e o pod removido pode ser justamente o que está com a mensagem: o lote é interrompido como num deploy (ver critério 2);
- a métrica perde significado: não dá mais para saber se a API escalou por demanda real ou por causa do batch.
Na abordagem A, o HPA da API continua reagindo só ao tráfego.
5. Quando o destino cai: retry, DLQ e redrive#
Imagine o SNS indisponível por uma hora.
- Abordagem B: o consumidor tenta publicar, falha, e o processamento para. A mensagem não é apagada: volta à fila depois do visibility timeout, e a nova tentativa segue de onde parou, pelo status no banco, e falha de novo enquanto o SNS estiver fora. Cada tentativa conta um recebimento; atingido o
maxReceiveCount(o limite de recebimentos da redrive policy), a mensagem, que representa o lote inteiro, vai para a DLQ. O intervalo entre as tentativas é o próprio visibility timeout: se ele foi dimensionado para cobrir o lote (critério 6), uma queda de uma hora pode passar entre duas tentativas; se é curto e o consumidor o estende enquanto processa, as tentativas se esgotam em minutos. Na DLQ, nada retoma sozinho: os pendentes ficam no banco até alguém, ou uma automação, fazer o redrive da mensagem para a fila principal (SQS — DLQ redrive), ou até o próximo disparo. E a DLQ tem prazo: a retenção conta desde o envio original, então a mensagem esquecida lá expira (SQS — Dead-letter queues). Ela também não separa as causas: uma queda do SNS e um registro ruim que derruba o consumidor chegam lá do mesmo jeito, como o lote inteiro. - Abordagem A: o SDK da AWS tenta de novo algumas vezes, com backoff. Esgotadas as tentativas, o step falha no chunk em andamento, o job sai com exit code diferente de zero e os registros ainda não enviados continuam pendentes no banco. As novas tentativas do
backoffLimitnão resolvem uma queda longa: o Kubernetes recria o pod com atraso de 10 s, 20 s, 40 s… (limitado a seis minutos), então, combackoffLimit: 2, todas acontecem com o SNS ainda fora. Quem pega os pendentes é a próxima execução agendada (num job diário, até 24 horas depois) ou um disparo manual assim que o SNS voltar:kubectl create job enviar-registros-manual --from=cronjob/enviar-registros. Não há mensagem parada numa DLQ nem redrive a fazer, mas há atraso. E, se o step usar skip para isolar itens inválidos, a exceção de infraestrutura não pode estar entre as puláveis: senão a queda do SNS vira uma leva de itens pulados (até oskipLimit), e uma falha de infraestrutura fica registrada como dado ruim.
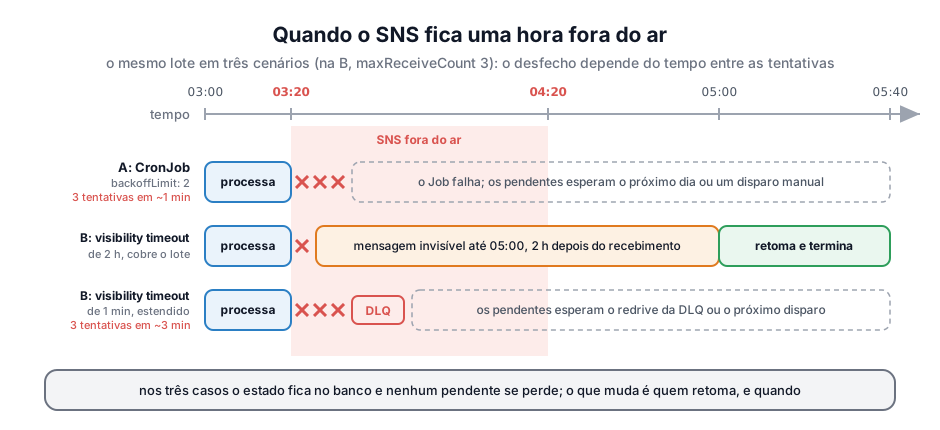
Na B, dá para controlar o intervalo entre as tentativas: o Spring Cloud AWS traz um ExponentialBackoffErrorHandler, que, a cada falha, muda o visibility timeout da mensagem para um valor que cresce com o número de entregas, e dá para automatizar o redrive. Mas é desenho e código a mais, e o backoff precisa ser dimensionado junto com o maxReceiveCount. Há ainda o risco de retry em várias camadas ao mesmo tempo: SDK, eventual retry no listener e reentrega da fila. O artigo Timeouts, retries, and backoff with jitter, da Amazon Builders’ Library, recomenda concentrar o retry num único ponto da pilha, porque cada camada extra multiplica a carga sobre quem já está com problema.
6. Uma mensagem para o lote inteiro#
Na abordagem B, a mensagem é só o gatilho: “processe os pendentes”. Quem sabe o que já foi feito é o banco, e quem lê a lista é o consumidor, não o endpoint. O desenho é simples, mas o lote inteiro fica preso a uma mensagem:
- Um pod só. O lote roda inteiro no pod que recebeu a mensagem, que continua atendendo a sua parte das requisições (critério 1). As outras réplicas não têm o que consumir, então não há paralelismo entre pods.
- O visibility timeout precisa cobrir o lote. Enquanto o consumidor trabalha, a mensagem continua na fila, só invisível para os outros. Se o prazo vence antes do fim, ela volta a ficar visível, outro consumidor a recebe e começa o mesmo lote: dois consumidores lendo os mesmos pendentes ao mesmo tempo. O padrão da fila é 30 segundos, e o Spring Cloud AWS, numa fila standard, define a visibilidade uma vez só, no recebimento (Spring Cloud AWS — SQS). Ou o prazo da fila cobre o lote inteiro, ou o consumidor o estende enquanto processa (o argumento
Visibilitydo listener tem o métodochangeTo()). E há um teto: 12 horas contadas a partir do recebimento, que as extensões não renovam (SQS — Visibility timeout). - A retomada espera o prazo. Se o pod morre (deploy, OOM, redução do HPA), a mensagem só reaparece quando o visibility timeout expira. Um prazo longo, para cobrir o lote, atrasa a retomada na mesma medida; um curto, estendido enquanto processa, retoma logo, mas é código a mais.
- Um registro ruim trava o lote. Se o consumidor lança exceção num registro, a mensagem inteira volta à fila e, depois de N tentativas, vai para a DLQ, parando no mesmo registro a cada vez. O consumidor precisa marcar o registro inválido e seguir, como a abordagem A também precisa (skip ou status).
Na abordagem A, o pod do job é a própria execução, sem prazo de visibilidade para dimensionar, e o reader do Spring Batch lê a lista em páginas, por chave (ver critério 11).
7. Um endpoint a mais para proteger#
Na abordagem B existe uma rota HTTP que dispara processamento em lote. Ela precisa ser protegida, e o CronJob, se autenticar para chamá-la: obter um token e montar a requisição, geralmente num script shell. Em ambientes regulados, expor lógica de negócio como endpoint pode não ser permitido. É esse o argumento de Chris Jones, no artigo já citado, para trocar o CronJob que chama a API via curl por um CronJob que roda a própria imagem (The New Stack).
8. Visibilidade por execução#
Na abordagem A, cada execução é um objeto com início, fim e resultado:
- o exit code do container diz ao Kubernetes se o pod deu certo e, esgotadas as tentativas do
backoffLimit, o Job fica como falho. O kube-state-metrics transforma isso em métricas, sem código adicional:kube_job_failed{condition="true"}indica o Job que falhou de vez. Não usekube_job_status_failedpara esse alerta: ela conta pods com falha e passa de zero mesmo quando a retentativa deu certo (kube-state-metrics — métricas de Job); - falha não é o único risco: se o CronJob não criar o Job, ou se o
Forbidpular horários atrás de um Job travado, nenhum Job falha e nenhum alerta de falha dispara. Para isso servekube_cronjob_status_last_successful_time, o horário do último sucesso:time() - kube_cronjob_status_last_successful_time{cronjob="enviar-registros"} > 26 * 3600avisa quando o job diário passa mais de 26 horas sem terminar com sucesso (kube-state-metrics — métricas de CronJob); - o Spring Batch grava cada execução nas tabelas de metadados, desde que o JobRepository esteja no banco (ver Como montar a abordagem A).
BATCH_JOB_EXECUTIONguarda início, fim e status.BATCH_STEP_EXECUTIONguarda quantos itens foram lidos (READ_COUNT), gravados (WRITE_COUNT), filtrados (FILTER_COUNT) e pulados (READ_SKIP_COUNT,PROCESS_SKIP_COUNT,WRITE_SKIP_COUNT) (Spring Batch — Meta-Data Schema).
Na abordagem B, a fila só mostra o gatilho: se a mensagem foi consumida, se voltou, se foi para a DLQ. Responder “O lote de hoje terminou? Quantos registros foram enviados?” exige criar tabela, contadores e lógica próprios. Não é impossível; é trabalho que, na abordagem A, já vem pronto.
9. Resposta perdida na rede: o gatilho dispara duas vezes#
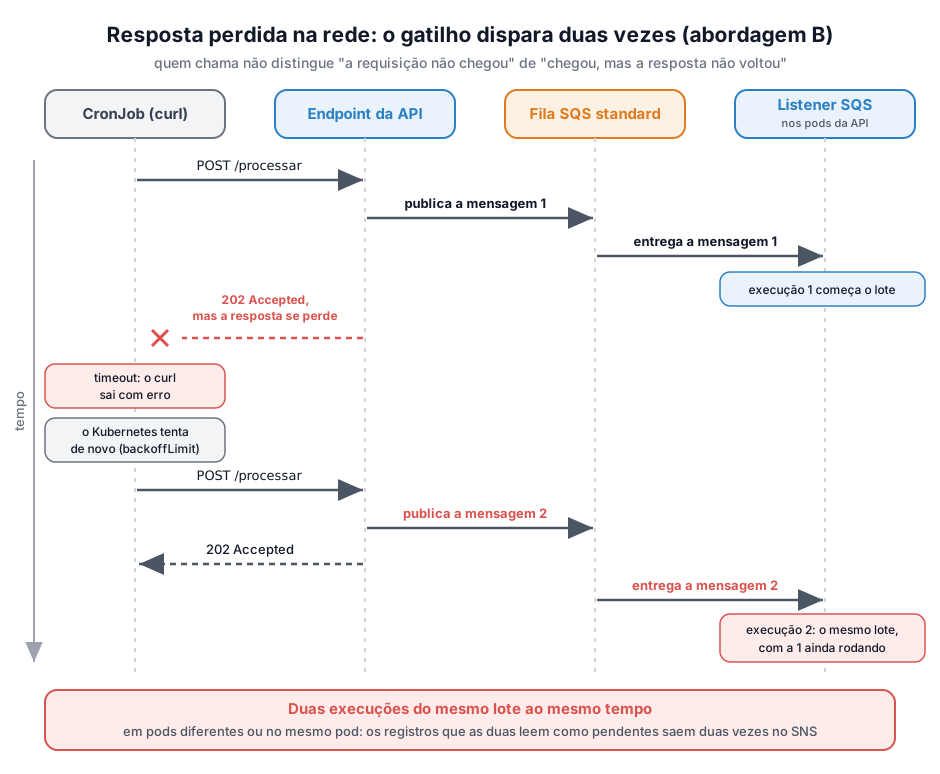
Na abordagem B, entre o agendador e o processamento existe uma chamada HTTP, e chamadas HTTP falham de um jeito traiçoeiro. O endpoint recebe a requisição, publica a mensagem e responde 202, mas a resposta se perde no caminho: timeout do próprio curl, conexão resetada porque o pod que recebeu a chamada está sendo encerrado num deploy, um proxy no meio. O curl termina com erro, o pod do CronJob sai com exit code diferente de zero e o Kubernetes, seguindo o backoffLimit, tenta de novo. O endpoint recebe a segunda chamada e publica uma segunda mensagem. Se houver retry configurado em algum proxy intermediário, como ingress ou service mesh, a requisição pode ser reenviada sem que o CronJob sequer perceba.
Isso pressupõe um curl bem configurado. Sem --fail, ele sai com código 0 mesmo quando a API responde 500 ou 401, e o CronJob registra sucesso sem o lote ter rodado; sem --max-time, ele não tem prazo para desistir. Use curl --fail --max-time <segundos>.
O problema é estrutural: quem chama não consegue distinguir “a requisição não chegou” de “a requisição chegou, mas a resposta não voltou”. A Amazon Builders’ Library descreve exatamente esse dilema: depois de um timeout, quem chamou não sabe se a operação aconteceu, e repetir a chamada pode duplicar o efeito. A saída é tornar a operação idempotente (Making retries safe with idempotent APIs). Na abordagem B, isso significa uma chave de idempotência, como a data de referência. No gatilho, uma fila FIFO resolve parte do problema: com o MessageDeduplicationId igual à data, uma segunda mensagem enviada em até 5 minutos é aceita, mas não é entregue, o que cobre o retry rápido do Kubernetes, mas não uma nova chamada mais tarde (SQS — Exactly-once processing). O resto fica com o consumidor.
A coluna de status no banco ajuda, mas não resolve sozinha. Se a segunda mensagem chega depois que a primeira terminou, não encontra pendentes e não faz nada. O problema é quando as duas rodam juntas, que é justamente o caso do retry rápido: dois pods leem os mesmos registros como pendentes antes que qualquer um marque “enviado”, e cada registro sai duas vezes. Evitar isso exige que o consumidor reserve cada registro com uma atualização condicional antes de enviar, ou que só um consumidor processe o lote por vez, com um lock no banco que expire se o pod morrer (como o do ShedLock). Mais uma peça a construir.
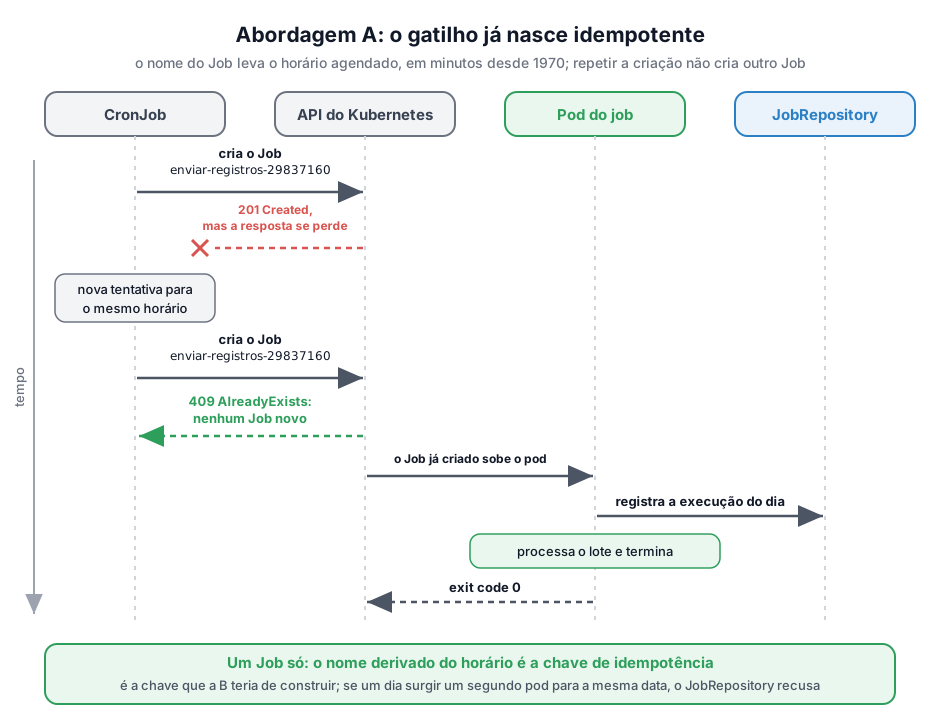
Na abordagem A, esse modo de falha não aparece, mas não por falta de rede no caminho. O controlador do CronJob também cria o Job com uma chamada ao API server, e essa resposta também pode se perder. A diferença é que o Kubernetes já tornou essa chamada idempotente: o nome do Job é derivado do horário agendado, e uma nova tentativa para o mesmo horário recebe AlreadyExists em vez de criar outro Job (código do controlador). É a chave de idempotência que a abordagem B teria de construir. Dali em diante, o processamento é o próprio pod, e o resultado é o exit code dele, sem resposta HTTP no meio. O que sobra são os casos raros documentados (critério 10), barrados pelo JobRepository.
10. Outras fontes de duplicidade#
Além do gatilho HTTP, há outras fontes de duplicidade, e nem todas dependem da escolha:
- O próprio CronJob. A documentação do Kubernetes avisa que a criação é aproximada: em certas circunstâncias, um CronJob pode criar dois Jobs, ou nenhum, e por isso os jobs devem ser idempotentes (Kubernetes — CronJob). A página de Job acrescenta que, mesmo com um único pod e
restartPolicy: Never, o mesmo programa pode às vezes ser iniciado duas vezes (Kubernetes — Jobs). Na abordagem A, quem cobre isso é o JobRepository do Spring Batch, desde que a data de referência seja o parâmetro identificador do job (ver Como montar a abordagem A). Ele recusa uma nova execução de uma instância que já terminou com sucesso ou que ainda está rodando; se a anterior falhou, a nova execução é um restart da mesma instância, que é o que se quer. Se dois pods tentarem criar a mesma instância ao mesmo tempo, só um consegue: a criação roda em transaçãoSERIALIZABLE(Spring Batch — Configuring a JobRepository), e a tabelaBATCH_JOB_INSTANCEtem restrição única em (JOB_NAME,JOB_KEY). Nos testes, com duas JVMs disparadas juntas para a mesma data, sempre uma processou e a outra saiu com erro, sem publicação duplicada. A execução recusada aparece como Job com falha no Kubernetes: é ruído esperado, não erro. OconcurrencyPolicy: Forbidcompleta a proteção, impedindo, em regra, que uma execução comece antes de a anterior terminar. Na abordagem B, um segundo Job faz uma segunda chamada ao endpoint, e a proteção é a do critério 9. - A reentrega da fila (só na B). A fila standard do SQS entrega cada mensagem pelo menos uma vez e, ocasionalmente, mais de uma (SQS — Standard queues). Com uma mensagem por lote, uma cópia é um segundo consumidor rodando o mesmo lote: o cenário do critério 9, sem nenhuma falha de rede, e com a mesma proteção.
- A publicação no SNS. Publicar e só depois marcar o registro deixa uma janela: se o processo cair entre as duas operações, o registro é enviado de novo na próxima tentativa. Na B, a janela é de um registro; na A, é do tamanho do chunk: se a transação do chunk é desfeita depois da publicação, todos os itens dele saem de novo. E, com
PublishBatch, a chamada pode voltar 200 com parte das entradas recusadas, então o writer precisa conferir as falhas da resposta antes de marcar os registros como enviados (Amazon SNS — PublishBatch). Em qualquer caso, os assinantes do tópico devem ser idempotentes. É a mesma janela do post Efeito externo sem registro local, agora com o SNS no lugar do adquirente de pagamentos.
11. Retomar de onde parou: empate#
As duas abordagens conseguem retomar de onde pararam. Na B, pela reentrega da mensagem e pela coluna de status, que diz o que ainda falta. Na A, pelo padrão process indicator descrito na documentação do Spring Batch: uma coluna marca os registros processados e o reader traz só os pendentes (Spring Batch — Preventing State Persistence).
Dois detalhes fazem esse padrão funcionar. O primeiro é o assunto da própria página citada: o reader deve usar saveState(false). Com o padrão (true), um reader por cursor, no restart, avança a quantidade de itens já lidos numa consulta que não traz mais os processados, e registros pendentes ficam para trás. O segundo: se a leitura for paginada, pagine por chave, não por offset. O JdbcPagingItemReader busca cada página a partir da última chave lida (o sortKey, que precisa ser única); já o JpaPagingItemReader e o RepositoryItemReader usam offset, então cada página marcada como enviada sai do filtro, e o offset da página seguinte pula a mesma quantidade de pendentes (Spring Batch — Database).
A diferença entre as abordagens não está em conseguir retomar, e sim em como cada uma se comporta quando a interrupção vem de um deploy (critério 2) ou de uma indisponibilidade do destino (critério 5).
Onde a abordagem B ganha#
- Retomada automática. Se o consumidor falha ou o pod morre, a mensagem volta sozinha depois do visibility timeout, e outro pod segue de onde parou, pelo status no banco. O Twelve-Factor recomenda exatamente isso para workers, no fator IX (Disposability): uma fila que devolva o trabalho quando o processo morre. Na abordagem A, o
backoffLimitretoma uma falha comum, mas um pod morto no meio deixa a execuçãoSTARTED, e as novas tentativas são recusadas até alguém destravá-la (ver “O preço da abordagem A”). O modelo de worker com fila é legítimo; o problema é consumi-la dentro da API. - Um caminho para paralelizar. Com uma mensagem por execução, a B também processa o lote num pod só. Mas a fila já está lá: se o volume crescer, o lote pode ser dividido em várias mensagens (por faixa de ids, por exemplo), e os consumidores, escalados pela profundidade da fila, inclusive até zero, com o KEDA. A abordagem A também paraleliza, mas o grau de paralelismo é definido antes da execução e não cresce sozinho com o volume. No Spring Batch, o step multi-thread processa os itens de cada chunk em várias threads dentro do mesmo pod, enquanto a leitura e a escrita continuam em série; no particionamento, os dados são divididos no início, e o step só termina quando a última partição termina (um
gridSizemaior que o número de threads deixa os blocos menores e reduz essa espera). Com Indexed Jobs no Kubernetes, o trabalho de cada índice também é fixado de antemão. Antes de otimizar, vale o conselho da própria documentação do Spring Batch: muitos problemas se resolvem com um job de uma thread e um processo, então meça primeiro. - Sem custo de inicialização. Os pods já estão rodando, com a JVM aquecida. A abordagem A sobe uma JVM a cada execução, o que é irrelevante para um job diário, mas pesa num job que roda a cada minuto.
- Disparo sob demanda e fluxo contínuo. Qualquer sistema pode disparar o processamento a qualquer momento, chamando o endpoint. E, se os itens chegam ao longo do dia como eventos, e não como uma lista fixa, a fila, aí com uma mensagem por item, é o modelo natural. Na abordagem A, o disparo fora de hora existe (
kubectl create job --from=cronjob/…), mas é operação, não integração. - Menos conceitos novos. Não há Spring Batch para aprender nem tabelas de metadados para manter; em troca, entram DLQ, visibility timeout e redrive.
O preço da abordagem A#
- Uma JVM por execução. Alguns segundos de inicialização a cada rodada.
- Idiossincrasias do CronJob. Ele pode criar dois Jobs ou nenhum: a idempotência é obrigatória, e o alerta de “não rodou” também (critério 8).
- O pod do job não é imortal. Drenagem de nó, OOMKill e o próprio
activeDeadlineSecondstambém o encerram. Se o processo morre sem atualizar o JobRepository, a execução fica comoSTARTED, e toda nova tentativa com a mesma data, inclusive as dobackoffLimit, é recusada (JobExecutionAlreadyRunningException) até alguém marcá-la comoFAILED. Num teste com Spring Boot 4.1.1, até um SIGTERM terminou assim: o Spring Boot fechou o pool de conexões com o step ainda rodando. Até o Spring Batch 5, destravar exigia umUPDATEmanual nas tabelas (Spring blog); no 6, existeJobOperator.recover(...), mas alguém ainda precisa chamá-lo (Spring Batch — Recovering a job). A execução do dia seguinte, com outra data, não é afetada. - Paralelismo definido antes da execução. Se um dia o lote precisar de elasticidade, a fila oferece o caminho (dividir o lote em várias mensagens), e o pod do job, não.
- Release acoplado. Usar a mesma imagem significa que cada release da API leva junto uma nova versão do job, aplicada na próxima execução (desde que o pipeline atualize também a imagem do CronJob). Se os dois precisarem evoluir em ritmos diferentes, separe em módulos e imagens.
- Curva de aprendizado e manutenção. Mais um framework e as tabelas de metadados, que crescem sem parar: o Spring Batch não tem equivalente ao
ttlSecondsAfterFinisheddo Job, e a limpeza fica por sua conta. O Spring Batch, porém, é opcional: umApplicationRunnercom a coluna de status também funciona, sem o histórico por execução e a proteção do JobRepository.
Resumo#
| Critério | A — CronJob | B — Endpoint + SQS |
|---|---|---|
| Disputa de recursos com a API | Pod próprio | Mesmo processo |
| Deploy durante o processamento | Não afeta o job | Interrompe o lote, que só volta depois do visibility timeout, em outra versão |
| Recurso reservado | Só durante a execução | Folga para o pico do batch, o dia inteiro |
| Autoscaling da API | Reage só ao tráfego | Reage também ao batch |
| Destino fora do ar | Job falha; a próxima execução (ou um disparo manual) retoma | A mensagem volta à fila até cair na DLQ; retoma com redrive ou no próximo disparo |
| Leitura da lista | No pod do job | No consumidor, dentro da API |
| Lote longo | Só o activeDeadlineSeconds que você definir | O visibility timeout precisa cobri-lo (teto de 12 h) |
| Endpoint a proteger | Não existe | Existe |
| Visibilidade por execução | Pronta (Job + tabelas BATCH_*, com o JobRepository no banco) | Precisa ser construída |
| Resposta perdida na rede | Não acontece: a criação do Job já é idempotente | Segunda mensagem: dois pods no mesmo lote |
| Duplicidade do CronJob | JobRepository (data de referência) + Forbid | Controle próprio (critério 9) |
| Retomar de onde parou | Coluna de status (process indicator); pod morto exige recover | Coluna de status; a mensagem volta sozinha |
| Falha isolada por item | Precisa configurar (skip, status) | Precisa programar (status); senão, a mensagem inteira volta |
| Paralelismo | Definido antes da execução | Um pod só: a mensagem é uma |
| Custo de inicialização | JVM a cada execução | Pods já rodando |
| Disparo sob demanda | Manual (kubectl create job --from) | Natural |
| Conceitos novos | Spring Batch (opcional) | Fila, DLQ, visibility timeout, redrive |
Como montar a abordagem A#
O que segue foi testado com Spring Boot 4.1.1 (Spring Batch 6.0.5), Java 21 e PostgreSQL 16, nos cenários que os critérios descrevem: execução normal, falha no meio do lote, nova execução no mesmo dia e no dia seguinte, duas execuções simultâneas, SIGKILL e SIGTERM no meio do processamento.
A dependência. No Spring Boot 4, o spring-boot-starter-batch sozinho usa o modo sem banco do Spring Batch 6 (ResourcelessJobRepository): os metadados ficam em memória e somem quando o pod termina. Sem tabelas BATCH_*, sem histórico de execuções e sem proteção contra uma segunda execução, ou seja, sem o que os critérios 8 a 10 descrevem. O JobRepository no banco vem do spring-boot-starter-batch-jdbc (no Spring Boot 3, o spring-boot-starter-batch já trazia o JDBC; ver o Spring Boot 4.0 Migration Guide):
<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-batch-jdbc</artifactId></dependency>As tabelas precisam existir no banco. Por padrão (spring.batch.jdbc.initialize-schema: embedded), o Spring Boot só cria o schema do Spring Batch em banco embutido; num PostgreSQL, a primeira execução falha com relation "batch_job_instance" does not exist. No teste usei initialize-schema: always; em produção, o caminho natural é aplicar por Flyway ou Liquibase o schema-postgresql.sql que vem no spring-batch-core (em org/springframework/batch/core/).
Os perfis. Uma imagem, dois perfis. Os beans de Job e Step ficam sob @Profile("batch"). O application.yml é a base de todos os perfis e desliga a execução automática de jobs, que é o que vale na API (ela roda sem perfil ativo). O application-batch.yml só sobrescreve o que declara, por isso religa a execução explicitamente:
spring: batch: job: enabled: falsespring: main: web-application-type: none datasource: hikari: maximum-pool-size: 2 # pool pequeno: o banco é compartilhado com a API batch: job: enabled: true # religa o que o application.yml desligou name: enviarRegistrosJob jdbc: initialize-schema: always # ou migração por Flyway/Liquibase (ver acima)Sem o enabled: true, o pod no perfil batch sobe, não executa job nenhum e sai com código 0, e o Kubernetes registra sucesso todo dia.
O web-application-type: none tira só o servidor web. O resto do contexto sobe igual no pod do job: listeners de fila (@SqsListener, @KafkaListener), tarefas @Scheduled e rotinas de aquecimento em ApplicationRunner passam a trabalhar ali dentro, disputando CPU, memória e conexões com o lote. Coloque esses beans, e a classe com @EnableScheduling, sob @Profile("!batch").
O exit code. O main propaga o exit code só no perfil batch:
@SpringBootApplicationpublic class App {
    public static void main(String[] args) {        var ctx = SpringApplication.run(App.class, args);        if (ctx.getEnvironment().acceptsProfiles(Profiles.of("batch"))) {            System.exit(SpringApplication.exit(ctx));        }    }}
Com o Spring Batch, o Spring Boot registra um ExitCodeGenerator que devolve código diferente de zero quando o job não termina COMPLETED; no teste, um job FAILED saiu com 5, a posição de FAILED no enum BatchStatus (Spring Boot — Application Exit). Sem o System.exit, o processo sai com 0 mesmo quando o job falha, e o Kubernetes registra sucesso. Na API, sem o perfil batch, o main não chama System.exit, e a aplicação continua no ar.
A data de referência. É ela que faz de cada dia uma instância própria no JobRepository e que permite recusar a execução duplicada dos critérios 9 e 10. O Kubernetes não calcula datas nos args sem um shell, e, no Spring Batch 6, quando o job tem um incrementer, os parâmetros passados na linha de comando são ignorados (fica só um aviso no log). Por isso quem gera a data é o incrementer do job, no mesmo fuso do timeZone do CronJob:
// Uma JobInstance por dia: a data de referência é o parâmetro identificador@BeanJob enviarRegistrosJob(JobRepository jobRepository, Step enviarRegistrosStep) { return new JobBuilder("enviarRegistrosJob", jobRepository) .incrementer(anteriores -> new JobParametersBuilder() .addLocalDate("dataReferencia", LocalDate.now(ZoneId.of("America/Sao_Paulo"))) .toJobParameters()) .start(enviarRegistrosStep) .build();}O que aconteceu em cada caso, nos testes:
- primeira execução do dia:
COMPLETED, exit code 0; - nova execução no mesmo dia, depois de um
COMPLETED: recusada (JobInstanceAlreadyCompleteException), exit code 1; - nova execução no mesmo dia, depois de um
FAILED: restart da mesma instância, e o reader lê só os pendentes; - no dia seguinte: uma instância nova.
Sem parâmetro nenhum, o job roda uma vez na vida: no Spring Batch 6, a instância de parâmetros vazios fica COMPLETED no primeiro dia, e toda execução a partir do segundo é recusada. Com um RunIdIncrementer, acontece o contrário: cada execução vira uma instância nova, e nada é recusado.
Configuração completa do job (testada com Spring Boot 4.1.1 e Spring Batch 6.0.5)
O SNS está simulado (o writer grava numa tabela publicacao e registra no log); no serviço real, ali entra a chamada ao SnsClient. Três detalhes do Spring Batch 6 aparecem no código: as interfaces de item mudaram de pacote (org.springframework.batch.infrastructure.item); o step precisa de .transactionManager(...), senão usa um ResourcelessTransactionManager e o JDBC do writer fica fora da transação do chunk; e o reader pagina por chave, com saveState(false) (critério 11).
package br.com.exemplo;
import java.time.LocalDate;import java.time.ZoneId;import java.util.Map;
import javax.sql.DataSource;
import org.slf4j.Logger;import org.slf4j.LoggerFactory;import org.springframework.batch.core.job.Job;import org.springframework.batch.core.job.builder.JobBuilder;import org.springframework.batch.core.job.parameters.JobParametersBuilder;import org.springframework.batch.core.repository.JobRepository;import org.springframework.batch.core.step.Step;import org.springframework.batch.core.step.builder.StepBuilder;import org.springframework.batch.infrastructure.item.ItemProcessor;import org.springframework.batch.infrastructure.item.ItemWriter;import org.springframework.batch.infrastructure.item.database.JdbcPagingItemReader;import org.springframework.batch.infrastructure.item.database.Order;import org.springframework.batch.infrastructure.item.database.builder.JdbcPagingItemReaderBuilder;import org.springframework.context.annotation.Bean;import org.springframework.context.annotation.Configuration;import org.springframework.context.annotation.Profile;import org.springframework.jdbc.core.simple.JdbcClient;import org.springframework.transaction.PlatformTransactionManager;
@Configuration@Profile("batch")class EnviarRegistrosJobConfig {
    private static final Logger log = LoggerFactory.getLogger(EnviarRegistrosJobConfig.class);
    record Registro(long id, String payload, String status) {}
    // Uma JobInstance por dia: a data de referência é o parâmetro identificador    @Bean    Job enviarRegistrosJob(JobRepository jobRepository, Step enviarRegistrosStep) {        return new JobBuilder("enviarRegistrosJob", jobRepository)                .incrementer(anteriores -> new JobParametersBuilder()                        .addLocalDate("dataReferencia",                                LocalDate.now(ZoneId.of("America/Sao_Paulo")))                        .toJobParameters())                .start(enviarRegistrosStep)                .build();    }
    @Bean    Step enviarRegistrosStep(JobRepository jobRepository, PlatformTransactionManager transactionManager,            JdbcPagingItemReader<Registro> pendentes, JdbcClient jdbc) {        return new StepBuilder("enviarRegistrosStep", jobRepository)                .<Registro, Registro>chunk(100)                .transactionManager(transactionManager)                .reader(pendentes)                .processor(validar())                .writer(publicarEMarcar(jdbc))                .build();    }
    // Process indicator: só os PENDENTE; sem estado salvo, o restart relê o que falta    @Bean    JdbcPagingItemReader<Registro> pendentes(DataSource dataSource) throws Exception {        return new JdbcPagingItemReaderBuilder<Registro>()                .name("pendentes")                .dataSource(dataSource)                .selectClause("SELECT id, payload, status")                .fromClause("FROM registro")                .whereClause("WHERE status = 'PENDENTE'")                .sortKeys(Map.of("id", Order.ASCENDING))                .dataRowMapper(Registro.class)                .pageSize(100)                .saveState(false)                .build();    }
    private ItemProcessor<Registro, Registro> validar() {        return r -> new Registro(r.id(), r.payload(),                r.payload() == null || r.payload().isBlank() ? "INVALIDO" : "ENVIADO");    }
    private ItemWriter<Registro> publicarEMarcar(JdbcClient jdbc) {        return chunk -> {            for (Registro r : chunk) {                if (r.status().equals("ENVIADO")) {                    // simula o SNS; no serviço real: snsClient.publish(...)                    jdbc.sql("INSERT INTO publicacao (registro_id, payload) VALUES (?, ?)")                            .params(r.id(), r.payload())                            .update();                    log.info("Publicado no SNS: registro {}", r.id());                }                jdbc.sql("UPDATE registro SET status = ? WHERE id = ?")                        .params(r.status(), r.id())                        .update();            }        };    }}
O CronJob. Usa a mesma imagem da API. O que cada campo garante, e o que não garante, está no post Kubernetes CronJob — concorrência, retries e tempo máximo de execução:
apiVersion: batch/v1kind: CronJobmetadata: name: enviar-registrosspec: schedule: "0 3 * * *" timeZone: America/Sao_Paulo concurrencyPolicy: Forbid startingDeadlineSeconds: 3600 # atrasou mais de 1 h: pula e espera o próximo dia successfulJobsHistoryLimit: 3 failedJobsHistoryLimit: 3 jobTemplate: spec: backoffLimit: 2 activeDeadlineSeconds: 7200 # com Forbid, um Job travado bloquearia os próximos template: spec: restartPolicy: Never containers: - name: worker image: meu-servico:1.2.3 # a mesma imagem do Deployment da API env: - name: SPRING_PROFILES_ACTIVE value: batch resources: requests: cpu: 500m memory: 1Gi limits: cpu: "1" memory: 1GitimeZone: sem ele, o horário é lido no fuso do kube-controller-manager, em geral UTC, e as 03:00 viram meia-noite em Brasília, bem na virada da data que o incrementer calcula.activeDeadlineSeconds: comForbid, um Job travado faria o CronJob pular todas as execuções seguintes; o prazo derruba o Job e libera a agenda (e, como visto em “O preço da abordagem A”, a execução interrompida ficaSTARTED).startingDeadlineSeconds: se o Job não for criado até uma hora depois do horário, a execução é pulada, e os pendentes ficam para o dia seguinte.resources: os valores do exemplo do critério 3. Sem eles, o pod fica na classeBestEffort: não reserva nada no nó e é o primeiro a ser despejado. Comlimits.memory: 1Gi, a JVM usa por padrão só 25% disso para o heap; se a imagem não ajusta o heap, defina-XX:MaxRAMPercentage(The java Command).
Se o CronJob sair do mesmo template do Deployment (Helm, Kustomize), deixe de fora as probes de liveness e de startup: sem servidor web, ninguém responde ao /actuator/health, o kubelet mata o container no meio do job, e cada nova tentativa do backoffLimit falha do mesmo jeito.
Referências para essa configuração: Spring Boot — Spring Batch (execução do job na inicialização e as propriedades spring.batch.*), Spring Boot — Application Exit e Kubernetes — CronJob.
Conclusão#
Para uma lista fixa no banco, processada em horário agendado e com trabalho leve por item, a abordagem A vence nos critérios que mais pesam: isolamento de recursos, deploy da API sem interromper o job, recurso reservado só quando necessário, um gatilho que já nasce idempotente, nenhum lote preso ao prazo de uma mensagem e menos peças para operar. E a visibilidade por execução já vem pronta. Isso vale desde que ela seja montada com os cuidados da seção anterior: JobRepository no banco, data de referência como parâmetro identificador e um CronJob com fuso, prazos e recursos definidos.
A abordagem B passa à frente quando os itens chegam continuamente como eventos, quando o processamento por item é pesado ou variável, ou quando o volume pede elasticidade. Mas aí o desenho também muda: em vez de uma mensagem por execução, uma por item, ou por faixa de itens, consumidas num Deployment próprio, no estilo Web-Queue-Worker, e não dentro da API, onde os problemas dos critérios 1 a 4 continuam existindo. De preferência, escale esse Deployment pela profundidade da fila, inclusive até zero: parado o dia inteiro, ele volta ao problema do critério 3. E o gatilho nem precisa ser HTTP: o próprio CronJob da abordagem A pode ler a lista e enfileirar. Some o endpoint (critério 7), e a duplicidade do critério 9 só muda de lugar, para o produtor, que precisa marcar o que já enfileirou.
No cenário deste post, a fila consumida dentro da API também resolve. Mas, para chegar ao mesmo lugar, você constrói e opera mais peças, reserva recurso na API o dia inteiro, amarra o lote ao prazo de uma mensagem e mantém o processamento disputando espaço com quem atende o usuário.
Fontes#
- Michael T. Nygard — Release It! Design and Deploy Production-Ready Software, 2ª ed. (Pragmatic Bookshelf; padrão Bulkhead)
- Martin Kleppmann — Designing Data-Intensive Applications, 1ª ed., cap. 10 (Batch Processing) (O’Reilly, 2017); na 2ª ed., com Chris Riccomini, o tema está no cap. 11
- Verma et al. — Large-scale cluster management at Google with Borg (EuroSys 2015)
- The Twelve-Factor App — VIII. Concurrency e IX. Disposability
- Microsoft — Bulkhead pattern, Web-Queue-Worker architecture style e Best practices for background jobs
- Amazon Builders’ Library — Timeouts, retries, and backoff with jitter e Making retries safe with idempotent APIs
- Chris Jones — Rethinking Java @Scheduled Tasks in Kubernetes (The New Stack, 2023)
- Chris Jones — Alternative JAR Entry Points Using Java Dependency Injection Frameworks (AWS Open Source Blog) e código de exemplo
- Mahmoud Ben Hassine — Spring Batch on Kubernetes: Efficient batch processing at scale (Spring blog, 2021)
- Rohit Raveendran — Decoding the pod termination lifecycle in Kubernetes: a comprehensive guide (blog da CNCF, 2024)
- Kubernetes — CronJob, Jobs, término de pods, Resizing Pods, requests e limits, Horizontal Pod Autoscaling, Vertical Pod Autoscaling e Indexed Jobs
- Kubernetes — código do controlador de CronJob (nome do Job derivado do horário agendado)
- kube-state-metrics — métricas de Job e métricas de CronJob
- Spring Boot — Profiles, Spring Batch, Application Exit e Graceful Shutdown
- Spring Boot — Spring Boot 4.0 Migration Guide (Spring Batch sem banco por padrão e o
spring-boot-starter-batch-jdbc) - Spring Batch — What’s new in Spring Batch 6, Configuring a JobRepository, Advanced Meta-Data Usage, Meta-Data Schema, Preventing State Persistence, Database e Scaling and Parallel Processing
- Spring Cloud AWS — SQS (visibilidade da mensagem,
listenerShutdownTimeouteExponentialBackoffErrorHandler) - Amazon SQS — Standard queues, Visibility timeout, Dead-letter queues, DLQ redrive, Exactly-once processing (FIFO) e Pricing
- Amazon SNS — PublishBatch
- HikariCP — README
- KEDA — AWS SQS Queue scaler
- ShedLock — README
- Oracle — The java Command (
-XX:MaxRAMPercentage)